지시문 예시는 내부 칸에 두고 읽을 때 거른다
지시문의 가정 칸에만 두려고 한 문장이, 사용자가 정한 것처럼 보이는 소개 끝에 붙었습니다. 처음에는 한 번 잘못 나온 문장으로 보였는데, 이미 만든 소개가 다음 호출의 문맥에 실려 초안이 그 문장을 따라 쓰며 퍼졌습니다. 그래서 예시의 자리를 내부 칸으로 못박고, 새 소개를 읽는 코드에서 그 문장 패턴을 한 번 더 거르기로 했습니다.
이 글은 생성 모델에 계획 지시문을 주고, 그 출력을 다음 호출의 문맥으로 다시 넣는 분께 도움이 됩니다.
한눈에 보는 결론
- 제약: 사용자에게 보이는 소개에는 내부 가정 예시가 들어가면 안 되고, 이전 소개가 다음 문맥에 들어가도 그 문장이 다시 살아나면 안 됩니다.
- 결정: 지시문에서 예시는 assumptions 같은 내부 칸 전용이라고 못박고, 소개를 펼치는 지시문에도 가정 문장을 넣지 말라고 적었습니다. 그와 별도로, 새로 만든 소개를 읽을 때 그 문장 패턴을 제거합니다. 이미 저장한 글을 고치는 경로에는 이 거르기를 두지 않았습니다.
- 확인: 일반 예시로 소개 문자열에 가정 예시 문장을 넣은 뒤 거르기 함수를 돌리면 그 문장은 빠지고 본문은 남았습니다. 고친 뒤에는 새 대화에서 소개를 만들어 저장해 보니, 보이는 소개에 그 가정 문장이 없었습니다.
과제와 제약
목표는 공개 소개 초안을 만들되, 계획 단계에서만 쓰는 가정이 사용자 화면에 나가지 않게 하는 것이었습니다. 가정 예시는 「가정:」처럼 표시된 짧은 메모가 아니라, 소개 본문처럼 읽히는 완성된 문장이었습니다. 생성 결과를 다음 호출의 문맥으로 다시 넣는 구조라, 한 번 섞인 문장은 다음 초안의 재료가 됩니다. 지시문에서 예시를 없애 버리면 모델이 내부 칸을 어떻게 채울지 보기 어려워, 예시는 남기되 자리가 분명해야 했습니다.
어떤 방법을 골랐는지
지시문만 고쳐서 「예시는 복사하지 말라」고 적는 방법은, 이미 섞여 나온 문장이 다음 문맥에 남아 있으면 다시 따라 쓰일 수 있습니다. 반대로 읽는 쪽에서만 거르면, 같은 뜻의 문장이 조금 다른 표기로 나올 때 빠지지 않을 수 있고, 모델은 여전히 소개 칸에 그 문장을 쓰려 합니다. 그래서 계획 지시문에서 예시의 자리를 내부 칸으로 못박고, 소개를 펼치는 지시문에도 가정이나 설명을 넣지 말라고 적었습니다. 그와 별도로, 새로 만든 소개를 읽는 코드에서 그 패턴을 거르는 두 겹을 두었습니다.
기본 구조
생성 한 번의 출력은 끝이 아닙니다. 그 출력이 다음 호출의 문맥으로 들어가면, 잘못된 문장도 다음 초안의 입력이 됩니다.
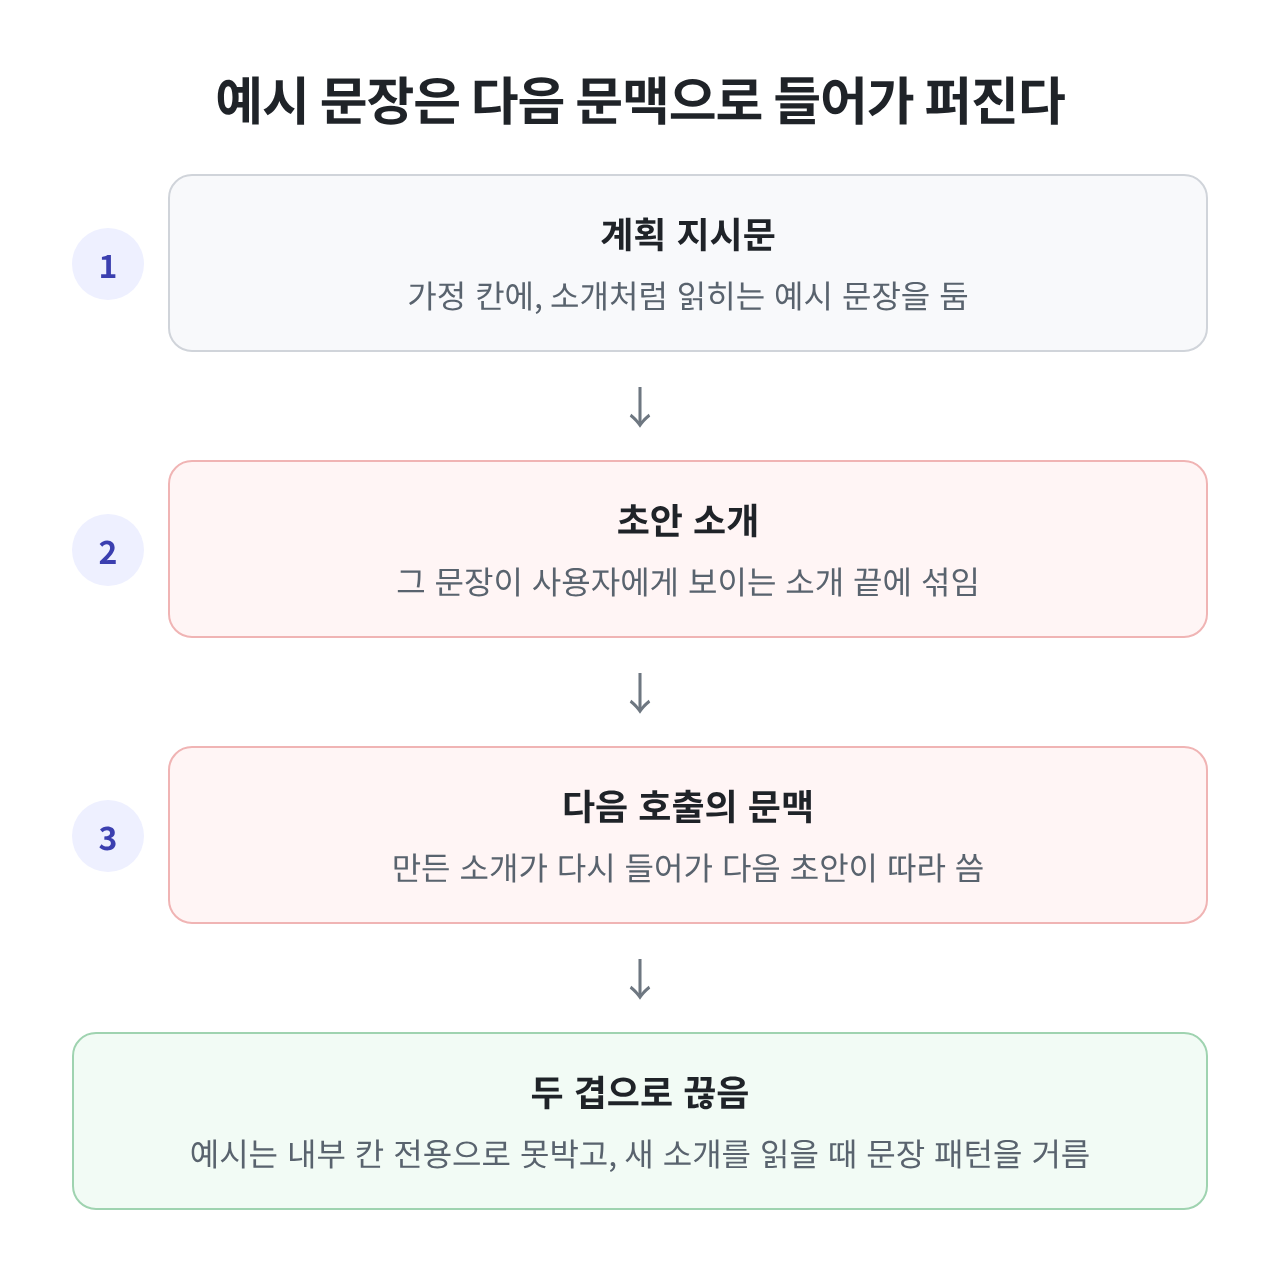
실제 고친 모양은, 지시문에서 예시가 들어갈 칸을 명시하고, 새로 만든 소개를 읽을 때 그 예시 문장을 빼는 쪽입니다. 아래는 그 구조를 일반 예시로 옮긴 코드입니다. 제품 지시문 원문이나 제품 거르기 코드가 아닙니다.
const PLAN_PROMPT = `당신은 공개 소개 초안을 만듭니다.
assumptions 칸에는 내부 가정만 적습니다. 이 칸의 문장은 사용자에게 보여 주지 않습니다.
description 칸에는 사용자에게 보일 문장만 적습니다.

assumptions 예시(내부 전용, description에 복사하지 말 것):
- 따로 고르지 않아 매달 이어지는 요금제로 두었습니다.

출력 형식:
{"assumptions":["..."],"description":"..."}`

const DRAFT_PROMPT = `소개는 사용자에게 보이는 글입니다. 가정이나 설명 문장은 넣지 않습니다.`

function looksLikeAssumptionExample(sentence) {
  const unsaid = /따로 고르지 않아|별도로 정하지 않아/
  const decided = /두었습니다|정했습니다/
  return unsaid.test(sentence) && decided.test(sentence)
}

export function stripAssumptionExamples(text) {
  return text
    .split(/(?<=다\.)\s*/)
    .filter((sentence) => sentence && !looksLikeAssumptionExample(sentence))
    .join(' ')
    .trim()
}

export function parseNewDraft(raw) {
  const data = JSON.parse(raw)
  return {
    assumptions: data.assumptions ?? [],
    description: stripAssumptionExamples(String(data.description ?? '')),
  }
}
parseNewDraft는 새로 만든 소개를 읽을 때 씁니다. 이미 저장한 글을 고치는 경로에는 이 거르기를 두지 않았습니다.
섞인 뒤 막기까지
처음 판단: 한 번 어긋난 출력
공개 소개를 만드는 계획 호출을 돌리다가, 지시문에 적어 둔 가정 예시가 소개 끝에 붙은 것을 봤습니다. 그 문장은 소개 본문처럼 읽혀, 처음에는 그 한 번의 출력이 어긋난 것으로 봤습니다.
다음 문맥을 타고 번진 예시 문장
그 문장은 소개를 펼치는 단계에서 먼저 나왔고, 처음 출처는 계획 지시문의 가정 예시였습니다. 이미 만든 소개가 다음 호출의 문맥에 같이 실렸고, 다음 초안이 그 문장을 따라 쓰며 여러 결과에 퍼졌습니다. 출력만 한 번 고치면 끝날 문제가 아니었습니다. 문맥으로 다시 들어가는 입력을 같이 손봐야 했습니다.
내부 칸 고정과 읽기 단계 거르기
계획 지시문에서 가정 예시는 내부 칸 전용이라고 못박아, 소개 칸에 복사하지 말라고 적었습니다. 소개를 펼치는 지시문에도, 소개는 사용자에게 보이는 글이니 가정이나 설명을 넣지 말라고 적었습니다. 그와 별도로, 새로 만든 소개를 읽는 코드에서 「사용자가 고르지 않았다」는 말과 「그래서 이렇게 두었다」는 말이 한 문장에 같이 있는 패턴을 제거했습니다. 지시문이 어긋나도 화면에 나가기 전에 한 번 더 걸리게 하려는 선택이었습니다.
예시가 출력으로 번지는 이유
모델은 지시문의 규칙만 따르는 것이 아니라, 옆에 적어 둔 예시의 모양을 패턴으로 집어 다음 출력에 적용합니다. OpenAI 공식 문서의 few-shot 절은, 입력과 출력 예시를 프롬프트에 몇 개 넣으면 모델을 새 작업 쪽으로 이끌 수 있고, 모델이 그 예시에서 패턴을 스스로 집어 프롬프트에 적용한다고 적습니다. Brown 등의 논문도, 가중치를 바꾸지 않은 채 문맥에 과제 예시를 몇 개 보여 주면 모델이 그 다음 입력을 같은 방식으로 이어서 쓴다고 설명합니다.
그래서 가정 칸을 채우는 법이 궁금하다고 소개처럼 읽히는 예시를 지시문에 두면, 그 문장 자체가 소개 칸의 재료가 될 수 있습니다. 이미 나온 소개를 다음 문맥에 다시 넣으면, 한 번 섞인 문장은 다음 초안이 따라 쓸 예시가 됩니다. 지시문에 「복사하지 말라」고만 적어서는, 이 두 번째 입력을 막기 어렵습니다.
스키마로 칸을 나누는 방법과 비교
칸을 더 단단히 나누는 방법으로는, 모델이 JSON 스키마를 지키게 하는 structured output이 있습니다. OpenAI 문서는 structured output이 거절하지 않고 끝까지 만든 출력을, 넘겨 준 JSON 스키마에 맞추어 제한한다고 적습니다. JSON 모드만 켜면 유효한 JSON이 나온다는 점은 같지만, 스키마를 지킨다는 보장은 structured output에만 있습니다. 같은 문서는, 스키마가 담지 못한 업무 규칙은 응용 쪽에서 따로 검사해야 한다고도 적습니다.
이 일을 structured output만으로 맡기면, assumptions와 description이 다른 칸으로 나뉘는 쪽은 좋아질 수 있습니다. 다만 description이 문자열인 이상, 스키마는 그 칸에 어떤 문장이 들어가도 형식이 맞으면 통과시킵니다. 가정 예시가 소개 문장으로 들어가는 일은 스키마가 담지 못한 규칙이라, 칸을 나눈 뒤에도 소개를 읽는 쪽에서 그 패턴을 검사해야 합니다. 그래서 지금은 지시문에서 자리를 못박고, 새로 만든 소개를 읽을 때 거르는 두 겹을 두었습니다. structured output은 칸을 나누는 장치를 더할 때 다시 보면 됩니다.
한계
거르기는 「고르지 않았다」와 「두었다」가 한 문장에 같이 있는 패턴만 빼므로, 표현이 조금만 바뀌면 남을 수 있습니다. 지시문에서 자리를 못박는 일은 모델이 칸을 지키게 돕는 장치이지, 출력을 보증하지는 않습니다. 이미 저장한 글을 고치는 경로에는 이 거르기를 두지 않았으므로, 예전에 섞여 들어간 문장은 그 경로만으로는 빠지지 않습니다. 위 코드의 예시 문장과 거르기 결과는 일반 예시입니다.
확인 방법
지시문에 적어 둔 예시 문장이 소개 문자열에 들어간 입력을 만들고, parseNewDraft를 돌린 뒤 description에 그 문장이 없는지 봅니다. 같은 함수에 본문만 있는 입력을 넣으면 본문은 그대로 남아야 합니다. 실제 생성 흐름에서는 고친 뒤 새 대화에서 소개를 만들어 저장하고, 보이는 소개에 그 가정 문장이 다시 나타나는지를 봅니다.
일반 예시로 확인한 결과는 아래와 같습니다.
const leaked = JSON.stringify({
  assumptions: ['공개 전에 요금제를 확인한다'],
  description:
    '이번 달 혜택을 소개합니다. 따로 고르지 않아 매달 이어지는 요금제로 두었습니다.',
})

const parsed = parseNewDraft(leaked)
// parsed.description === '이번 달 혜택을 소개합니다.'
저는 예시 문장이 한 번 새어 나온 것만 고치면 된다고 먼저 봤습니다. 다시 보니 문제는 그 출력이 다음 호출의 문맥으로 들어가 초안이 따라 쓰는 쪽이었습니다. 지시문에서 자리를 못박고 새 소개를 읽는 쪽에서 같은 문장 패턴을 거른 뒤에는, 일반 예시와 새 대화에서 만든 소개 모두에서 그 예시가 빠졌습니다.
정리
- 지시문 예시는 출력으로 번질 수 있고, 다음 문맥에 들어가면 따라 퍼집니다.
- 예시의 자리는 내부 칸으로 못박고, 소개를 펼치는 지시문에도 가정을 넣지 말라고 적습니다.
- 새로 만든 소개를 읽을 때 그 문장 패턴을 한 번 더 거릅니다.
지시문 예시는 내부 칸에 두고, 공개 글을 읽을 때 한 번 더 거르려고 합니다.