정확성 때문에 버린 최적화는 다시 잰다
예전에 정확성 때문에 쓰지 않았던 직렬화 방식을, 입력 한 자가 무거워져 다시 써 봤습니다. 편집 문서 안에서 저장용 HTML을 만들면 쌓여 있는 Range를 브라우저가 같이 다루느라 입력이 밀릴 수 있어, document.implementation.createHTMLDocument로 분리된 문서를 만들고 그쪽에서 읽기로 했습니다. 처음 에디터를 만들 때 이 방법을 사용하지 않았던 이유는, 저장되는 문자열이 달라질 수 있다고 봤기 때문입니다. 다시 넣어 보니 입력 한 자의 멈춤은 줄었고, 그래서 문자열이 실제로 갈리는지부터 나눠 재기로 했습니다.
이 글은 에디터에서 저장용 HTML을 만드는 비용이 입력을 밀 때, 분리된 문서에서 직렬화해도 되는지를 가려야 하는 분께 도움이 됩니다.
한눈에 보는 결론
- 제약: 저장 문자열과 미리보기·발행 결과가 조용히 바뀌면 안 됩니다.
- 결정: 분리된 문서에서 innerHTML처럼 속성 그대로 읽는 경로인지를 확인한 뒤에 다시 씁니다.
- 확인: innerHTML은 두 문서에서 같았고, href·src 프로퍼티와 XMLSerializer만 갈렸습니다. 실험용 페이지에서 단락 350개와 Range 8만 개 기준 중앙값은 3ms와 0.2ms였고, 입력 한 자의 멈춤이 줄어드는 것도 확인했습니다.
과제와 제약
목표는 글 쓰는 화면에서 입력 한 자가 멈추는 시간을 줄이되, 저장한 HTML을 다시 열었을 때 화면과 문자열이 이전과 같게 두는 것입니다. 직렬화 비용을 피하는 일과, 저장 결과가 같은지는 다른 축이라, 속도만 보고 넣을 수는 없었습니다.
제약에 맞춰 고른 방법
선택지는 세 가지였습니다. 편집 문서에서 계속 직렬화하면 저장 결과는 그대로지만, Range가 쌓일수록 입력은 무거워질 수 있습니다. 분리된 문서에서 읽되 출력 비교를 생략하면 속도는 나지만, 저장된 HTML이 바뀌면 미리보기와 발행에 구멍이 납니다. 그래서 분리된 문서에서 만들되, 저장 결과가 같은 경로인지를 확인하고 쓰는 쪽을 택했습니다.
이 방법을 계속 쓰지 않는 편과, 체감만 보고 넣는 편은 쓰지 않기로 했습니다.
기본 구조
Tiptap의 getHTML은 편집 중인 문서를 HTML로 돌려 줍니다. 그 아래의 ProseMirror DOMSerializer.serializeFragment는 document 옵션을 받을 수 있고, 공식 문서는 브라우저가 아닐 때 노드를 만들 문서를 넘기라고 적습니다. createHTMLDocument가 만드는 문서는 지금 페이지와 분리되어 있고, 기준 주소는 about:blank입니다.
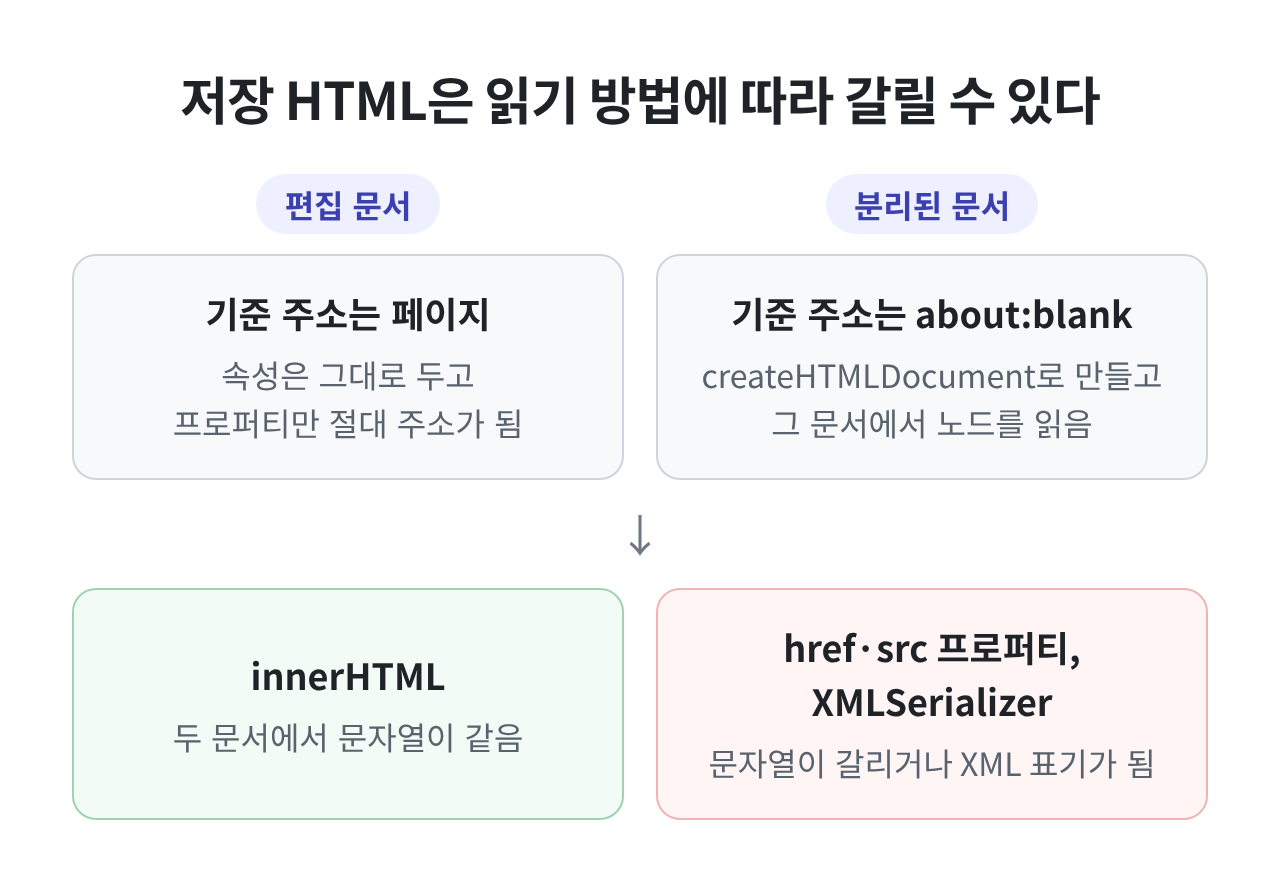
실제 고친 모양은, 분리된 문서에서 노드를 옮긴 뒤 innerHTML로만 읽는 함수입니다. href나 src 프로퍼티를 속성에 다시 쓰지 않습니다.
function serializeForSave(source) {
  const detached = document.implementation.createHTMLDocument('')
  const wrap = detached.createElement('div')
  wrap.appendChild(detached.importNode(source, true))
  return wrap.innerHTML
}
같은 마크업을 편집 문서와 분리된 문서에서 innerHTML로 읽으면 문자열이 같았습니다. href와 src 프로퍼티를 속성에 다시 쓰면 편집 문서에서는 https://example.com/about처럼 풀리고, 분리된 문서에서는 /about으로 남았습니다. XMLSerializer로 br을 읽으면 두 문서 모두 <br xmlns="http://www.w3.org/1999/xhtml" />가 되고, outerHTML은 <br>입니다.
다시 넣기까지
예전에 이 방법을 사용하지 않았던 이유
처음 에디터를 만들 때는, 분리된 문서에서 읽으면 저장 문자열이 달라질 수 있다고 보고 이 방식을 버렸습니다. 정확성을 지키려는 선택이었습니다.
다시 넣은 뒤 가벼워진 입력
입력 한 자가 무거워져, 예전에 버린 방식을 다시 넣었습니다. 속도가 나을 거라고 봤고, 실제로 입력 한 자의 멈춤은 줄었습니다.
읽기 경로에 따라 갈린 저장 문자열
그래서 버린 이유가 지금도 같은지 다시 쟀습니다. innerHTML처럼 속성 그대로 읽는 경로는 두 문서에서 같았고, 갈린 것은 확인된 읽기 방법뿐이었습니다. 같은 경로를 확인한 뒤에야 이 방식을 다시 쓸 수 있다고 봤습니다.
한계
분리된 문서의 기준 주소는 about:blank라, 상대 주소를 프로퍼티로 풀어 저장하면 결과가 갈립니다. XMLSerializer는 HTML이 아니라 XML 표기를 돌려 주므로, outerHTML이나 innerHTML과 같은 문자열이라고 보면 안 됩니다.
확인 방법
굵게, 기울임, 링크, 이미지, 목록처럼 실제로 쓰는 서식을 한 번씩 넣고, 저장한 뒤 다시 열었을 때 화면과 문자열이 같은지 봅니다. href·src를 절대 주소로 풀어 쓰거나 XMLSerializer로 저장하는 경로가 있으면 그 차이까지 대조합니다. 그리고 한 자 입력으로 멈춤이 줄었는지를 같이 봅니다.
저는 입력 한 자의 멈춤이 줄어든 것만으로 다시 쓰기로 결정하지 않았습니다. 예전에 버린 이유가 저장 문자열이 달라질 수 있다는 점이었고, 다시 재어 보니 innerHTML은 같았으며, 갈린 것은 href·src 프로퍼티와 XMLSerializer뿐이었습니다. 저장 문자열이 같은지 먼저 확인했고, 직접 입력해 보는 테스트에서도 UX 문제는 없었습니다.
정리
- 분리된 문서에서 innerHTML로 읽으면 편집 문서와 같았습니다.
- href·src 프로퍼티와 XMLSerializer는 갈리므로, 그 경로인지를 먼저 가릅니다.
- 속도만 보고 다시 넣지는 않습니다.
정확성 때문에 버린 최적화는, 버린 이유와 지금 출력부터 다시 재려고 합니다.